
Аренда NVIDIA DGX Spark 128 ГБ
Founders Edition в московском дата-центре партнёра — аренда NVIDIA DGX Spark 128 ГБ целиком, без соседей и виртуализации. Единый пул LPDDR5x на 128 ГБ, из которого под веса и контекст остаётся примерно 108 ГБ, вмещает модели на 70B–120B параметров, а для более крупных узлы объединяются в кластер до четырёх. Подходит для инференса, RAG и дообучения, когда модели тесно в видеокарте или в облачной H100 на 80 ГБ; чтение памяти — 273 ГБ/с. Система — DGX OS (Ubuntu) с CUDA и контейнерами NGC, подключение — SSH с правами root или JupyterLab. Цена фиксирована в рублях за сутки или месяц, договор с компанией или ИП, акт ежемесячно.
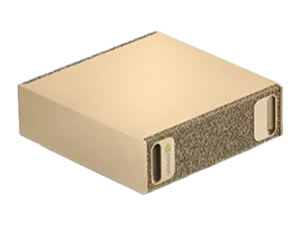
- Чип GB10 (Grace Blackwell): Blackwell-GPU с пиком 1 PFLOP в FP4 и 20-ядерный Arm-процессор (Cortex-X925 + Cortex-A725, по 10 ядер)
- Диск — NVMe, 4 ТБ. Сетевой адаптер ConnectX-7: два порта QSFP по 200 Гбит/с, плюс 10GbE
- Объединяется в кластер до 4 узлов; стоимость кластера рассчитываем по заявке
- Сумму депозита и порядок продления пришлём вместе с предложением
Цены
- Цены указаны без НДС, 5 % начисляется в счёте.
- Кластер 2–4 узла по ConnectX-7 рассчитываем индивидуально.
Характеристики
- GPU
- Blackwell GB10, 1 PFLOP FP4
- CPU
- 20× Arm (10× Cortex-X925 + 10× Cortex-A725)
- Память
- 128 ГБ LPDDR5x unified, ≈108 ГБ под модель
- Пропускная способность
- 273 ГБ/с
- Накопитель
- 4 ТБ NVMe
- Сеть
- ConnectX-7 200G + 10GbE
- ОС
- NVIDIA DGX OS (Ubuntu), CUDA, контейнеры NGC
- Доступ
- Root по SSH, JupyterLab
- Кластер
- 2–4 узла по заявке
- Размещение
- Дата-центр партнёра, Москва
- Питание
- ≈240 Вт
Характеристики — по данным производителя; ресурс под модель — оценка для DGX OS с рантаймом.
Вместимость моделей
Популярные модели при типовом квантовании и контексте — из 108 ГБ на узел.
Все моделиУсловия
- Работаем с юрлицами и ИП по договору
- Безналичная оплата по счёту, ЭДО
- Закрывающие документы — ежемесячно
- Депозит и порядок продления — в индивидуальном предложении
- Устройство только ваше: без соседей и общего доступа
Для кого
- Локальный инференс открытых LLM, которым тесно в видеокарте, — без облачных квот и почасовой оплаты
- Дообучение LoRA/QLoRA и исследования, где объём памяти важнее пиковой скорости
- RAG и корпоративные ассистенты на данных, которые нельзя отправлять во внешние API
- Связка сервисов на одной машине: модель, векторная база и API-шлюз
- Кластер 2–4 узла — когда веса не помещаются в одно устройство
Где не подходит
- Публичный сервис с сотнями одновременных запросов и обучение с нуля — это задачи для H100/H200
- Если модель меньше 32 ГБ, RTX 5090 ответит быстрее: здесь предел задаёт скорость чтения памяти
- Своих замеров токенов в секунду мы не публикуем — скорость проверяется на суточной аренде
Вопросы о модели
Общие вопросы- Зачем Spark, если есть облачная H100?
- Если нужен продакшен под нагрузку сотен людей, H100 — правильный выбор: одиночный запрос она обрабатывает многократно быстрее. Spark сильнее в другом: 128 ГБ памяти на выделенном устройстве за фиксированную плату в месяц, без почасового счёта и квот. Облачная H100, работающая круглосуточно, стоит в несколько раз больше.Сравнение с H100 и RTX 5090
- Во что упирается скорость генерации?
- В скорость чтения памяти — 273 ГБ/с. Чтобы выдать очередной токен, модель заново читает активные веса, поэтому темп генерации ограничен именно этой цифрой. Команде с моделями 70B–120B его хватает; публичный сервис с сотнями параллельных сессий он не потянет.Какие модели помещаются
- Какой будет скорость на моей модели?
- Её определяют модель, квантование, движок инференса и число параллельных запросов, поэтому одной цифры для всех случаев мы не даём. Самый точный способ — суточная аренда: развернёте свою модель и замерите скорость на реальных запросах.
- Получится ли запустить полный DeepSeek-V3 или R1?
- Нет: версии на 671B даже в 4-битном квантовании нужно порядка 440 ГБ, а четыре узла дают 4 × 10⁸ ГБ. Реалистичные варианты: gpt-oss-120b, Llama 3.3 70B и DeepSeek-R1-Distill-Llama 70B — в один узел, Qwen3 235B в int4 — в два.Расчёт для DeepSeek-V3 671B DeepSeek-R1-Distill-Llama 70B
- Когда RTX 5090 окажется быстрее?
- Когда модель умещается в её 32 ГБ: видеопамять RTX 5090 работает на 1,8 ТБ/с, у Spark — 273 ГБ/с. Модели от 70B видеокарте пришлось бы частично держать в RAM компьютера, а Spark загружает их целиком в 128 ГБ.Сравнить с RTX 5090
- Хватит ли младшей модели с 64 ГБ?
- Для моделей до ~30B — да: свободно под них около 48 ГБ. NVIDIA объявила стоимость $4 999; аренду этой версии принимаем по предзаказу. Для 70B и gpt-oss-120b нужна старшая версия, 128 ГБ.DGX Spark 64 ГБ
Другие конфигурации
- ASUS Ascent GX10 128 ГБ — 128 ГБ, ~108 ГБ под модель
- NVIDIA DGX Spark 64 ГБ — 64 ГБ, ~48 ГБ под модель