
DGX Spark или Mac Studio M3 Ultra: что выбрать для LLM
NVIDIA DGX Spark 128 ГБ · Mac Studio M3 Ultra 256 ГБ
По железу Mac Studio M3 Ultra с 256 ГБ сильнее: памяти вдвое больше, и читает он её в 3 раза быстрее. DGX Spark берёт экосистемой — CUDA, PyTorch и контейнеры NVIDIA работают на нём так же, как на серверных GPU, — и тем, что его не обязательно покупать. Для личной работы с самыми большими моделями удобнее Mac, для команды, сервиса и дообучения — Spark.
Характеристики
Открыть в сравнении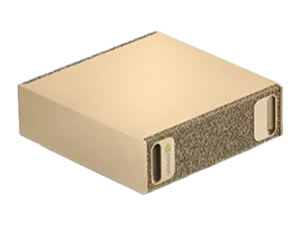 NVIDIA DGX Spark 128 ГБ | 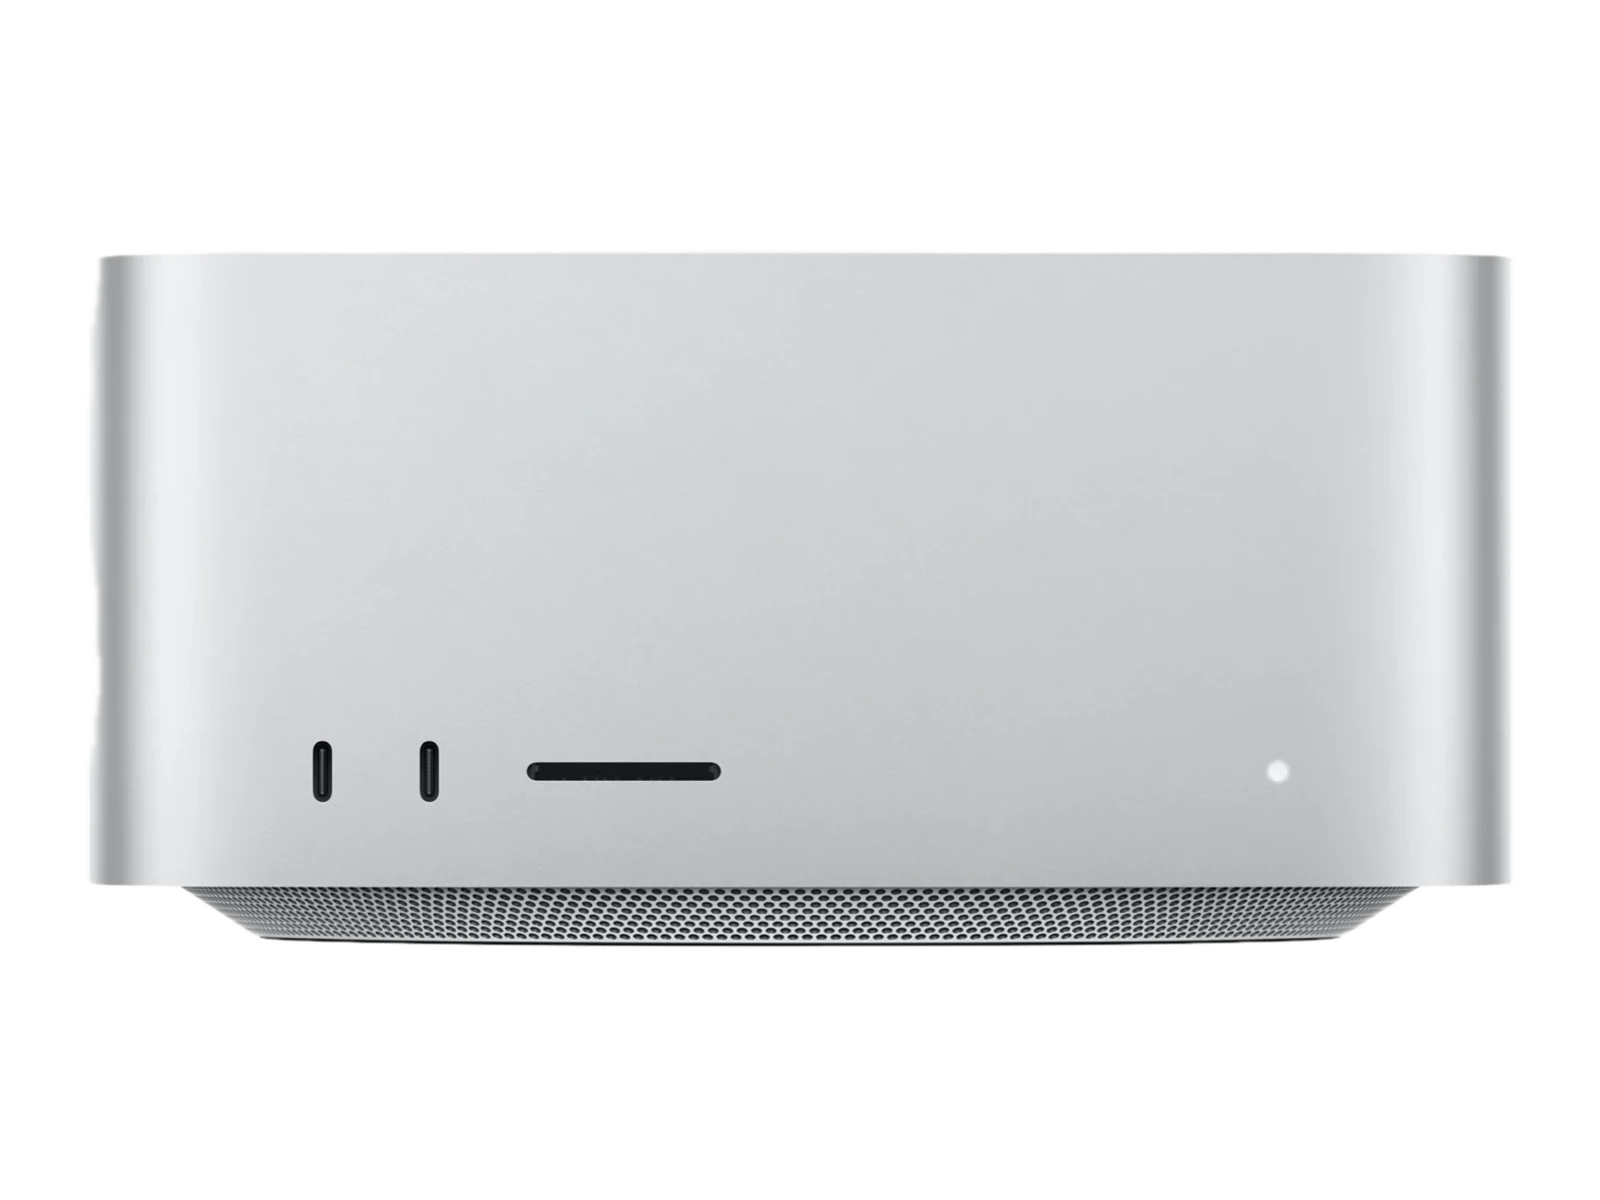 Mac Studio M3 Ultra 256 ГБ | |
|---|---|---|
| Память, ГБ | 128 | 256 |
| Под модель, ГБ (оценка) | 108 | 192 |
| Пропускная способность, ГБ/с | 273 | 819 |
| FP4, TFLOPS | 1 000 | — |
| Мощность, Вт | 240 | 270 |
| Форм-фактор | Настольный | Настольный |
| Цена покупки | 699 000 ₽ | 1 000 000 ₽ |
| Аренда в месяц | 49 000 ₽ | — |
| ГБ на 1 000 ₽ аренды | 2,61 | — |
| Примечания | Модели 70B–120B помещаются целиком благодаря 128 ГБ единой памяти; Аренда — 49 000 ₽/мес; покупка — от 699 тыс. ₽ | Объём 256 ГБ при скорости 819 ГБ/с — больше и быстрее, чем у Spark; Около 1 000 000 ₽; CUDA нет — только MLX или llama.cpp, дообучение в стеке NVIDIA недоступно; По умолчанию macOS отдаёт видеоядру около ¾ общей памяти (~192 ГБ из 256); лимит поднимается системной настройкой |
Отличия подсвечены. «Под модель» — сколько памяти остаётся под веса и контекст за вычетом системы или лимита видеопамяти.
Скорость генерации
Замеры из открытых источников. В строке — только результаты, снятые одной методикой на обеих машинах: тот же движок, модель, квант и нагрузка. Основное число — скорость генерации, токенов в секунду; ниже — скорость обработки промпта; источник и дата — в каждой строке. Где под числом стоит «вход + выход», это другая метрика: суммарная пропускная способность при параллельных запросах, входные и выходные токены вместе, — сравнивать её можно только внутри строки.
Какие модели влезают
Расчёт под свою модельС лимитом macOS около 192 ГБ под видеоядро Mac вмещает 25 моделей каталога из 32, DGX Spark — 22. Только на Mac запускаются Llama Nemotron Ultra 253B, Qwen3 235B-A22B, Command A 111B. Если же взять два Spark и связать их ConnectX-7, памяти под модель становится вдвое больше, и список вырастает до 26 — длиннее, чем у одного Mac.
Типовой квант и контекст каждой модели, одно устройство: под модель 108 и 192 ГБ.
Только в Mac Studio
- Llama Nemotron Ultra 253B ≈ 155,1 ГБ
- Qwen3 235B-A22B ≈ 137,5 ГБ
- Command A 111B ≈ 137,3 ГБ
Когда выбрать DGX Spark
- Код и инструменты на CUDA: vLLM, TensorRT-LLM, NeMo, образы NGC — всё, что потом развернётся на серверах с GPU NVIDIA.
- Модель должна работать как сервис для нескольких сотрудников с OpenAI-совместимым API — в дата-центре, а не на чьём-то столе.
- Нужно дообучение: LoRA или полный fine-tuning на PyTorch с CUDA.
- Бюджет помесячный: 49 000 ₽ в месяц вместо 1 000 000 ₽ разом.
Когда выбрать Mac Studio
- На одной машине без кластера нужны модели крупнее 108 ГБ: Llama Nemotron Ultra 253B, Qwen3 235B-A22B, Command A 111B.
- Вы работаете в MLX или llama.cpp на macOS, и CUDA не требуется.
- Компьютер нужен лично вам, тихий и компактный, а LLM — лишь часть его работы.
Стоимость: аренда или покупка
Посчитать в калькулятореMac Studio M3 Ultra с 256 ГБ стоит около 1 000 000 ₽ — это ≈20,4 мес. аренды Spark по 49 000 ₽. Сам Spark в покупке — от 699 000 ₽; при перепродаже за 60 % и электричестве 1 500 ₽ в месяц его покупка обгоняет аренду через 6 месяцев. Короткий проект или проверку гипотезы выгоднее сделать в аренде, а если модель будет годами работать у одного человека, имеет смысл считать покупку.
Вопросы
Что быстрее генерирует токены: Mac Studio M3 Ultra или DGX Spark?
Скорость генерации упирается в чтение памяти: 819 ГБ/с у Mac против 273 ГБ/с у Spark, и замеры это подтверждают — на Llama 3.1 8B в FP16 Mac генерирует примерно в 3,4 раза быстрее. Зато промпт на 8 тысяч токенов Spark обработал в 3,8 раза быстрее: тут решают вычисления, у Spark до 1 000 TFLOPS в FP4. Цифры и источники — в таблице «Скорость генерации».
Можно ли запустить CUDA-код на Mac Studio?
Нет. На Mac модели работают через Metal: MLX, llama.cpp, Ollama, LM Studio. Код под CUDA — серверные движки, скрипты обучения, многие контейнеры — придётся переписывать или искать замену.
Почему на Mac под модель доступны не все 256 ГБ?
macOS по умолчанию отдаёт видеоядру около трёх четвертей общей памяти — примерно 192 ГБ из 256. Лимит поднимается системной настройкой, но часть памяти всё равно нужна системе и приложениям.
Что выбрать для команды из нескольких человек?
Spark в дата-центре: к нему подключаются по SSH и API, он не зависит от чьего-то рабочего компьютера, а при росте нагрузки к нему добавляются узлы кластера. Mac лучше подходит как личная рабочая станция.
Другие сравнения
Все аналоги DGX Spark- DGX Spark или Ryzen AI Max+ 395: что выбрать для LLM128 и 128 ГБ · 273 и 256 ГБ/с
- DGX Spark и ASUS Ascent GX10: в чём разница128 и 128 ГБ · 273 и 273 ГБ/с
- DGX Spark или RTX 5090: что выбрать для LLM128 и 32 ГБ · 273 и 1 792 ГБ/с
- DGX Spark или H100: что выбрать для LLM128 и 80 ГБ · 273 и 3 350 ГБ/с
- DGX Spark 128 ГБ или 64 ГБ: какую версию выбрать128 и 64 ГБ · 273 и 273 ГБ/с